深度Q网络:DQN的那些事
在上一篇笔记中,我们学习了Q-learning算法:从强化学习的基本概念到 Q-learning 算法 | Adam8en の 8log
Q-learning是一种表格型方法,通过不断地更新Q表来得到最优Q值。然而这么做最大的问题在于——表格能存储的值是有限的,它只适用于状态与动作离散,且空间较小的情况。在状态空间巨大的任务里,我们需要新的方法:也就是我们今天介绍的DQN。
简单来说,DQN的核心思想在于用神经网络去拟合Q,但是这么做又会带来新的问题,下文我们会详细讲解这些问题,以及DQN是如何解决这些问题的。
我们先从一个游戏开始:Atari 2600 主机上的 Space Invaders
Space Invaders
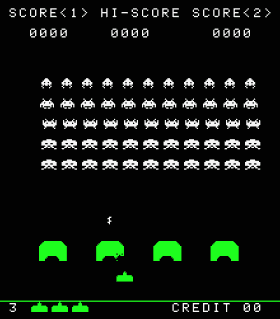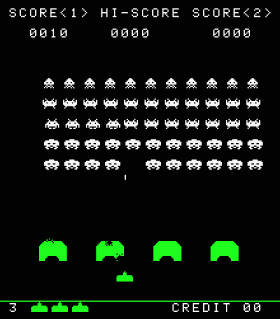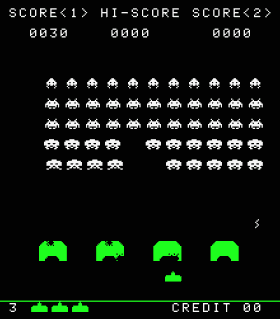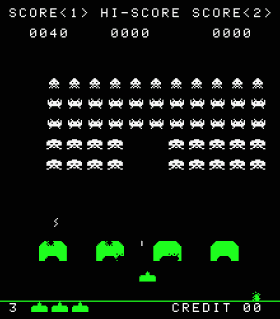
《太空侵略者》(Space Invaders)是雅达利(Atari)2600主机的销量王牌,1980年由雅达利获得太东授权后移植推出,凭一己之力把雅达利2600带成了国民级主机,当年卡带销量突破200万,成为第一款销售额破1亿美元的家用游戏
基本目标:玩家操控画面底部的激光炮台,左右移动躲避敌人攻击,并在侵略者抵达屏幕底端前将其全部消灭 。
——From ERNIE Bot
Space Invaders是强化学习的理想测试平台,它天然就具备RL的所有要素:
- 有明确的状态:游戏画面
- 有明确的动作空间:上下左右开火等
- 有明确的奖励:得分
- 有明确的终止条件:游戏结束
- 有复杂的长期决策:不是一步就能赢,需要多步规划
- 有高维输入:210×160×3 的像素,传统 Q 表根本存不下
可以看出它的状态空间是巨大的:单个帧由210×160像素组成,再算上RGB的三个通道,理论上存在256210×160×3=256100800个可能的观测值,这种时候就不太可能继续用Q表了。由此,我们提出了一条新的思路,即用神经网络等非线性函数去近似Q值。
DQN
预处理
在用神经网络之前,我们需要对任务进行预处理来降低状态的复杂性,以减少训练所需的计算时间。对于Space Invaders来说,主要包含四步:
-
消除闪烁
游戏中的外星人会不断地扇动翅膀,这种视觉效果是通过奇偶帧交替渲染来实现的。我们通过取当前帧和前一帧的像素最大值来合并表示一个物体。
-
提取亮度通道
游戏在变色,敌人的颜色不一,RGB带来的彩色视觉效果对于强化学习是不必要的,反而增加了计算复杂度。因此,我们对图像进行灰度处理,把RGB三通道减少为一。
-
缩放图像
调整像素密度,降低分辨率。将原先的210×160的图像大小压缩为84×84,虽然变得不清楚了,但是不妨碍我们后续对神经网络的训练,同时也减少了计算复杂度。
-
帧堆叠
在游戏环境里,单帧画面不包含运动信息,无法获知是往左飞还是往右飞、敌人在靠近还是远离等。所以单帧不满足马尔可夫性——因为下一步的状态不只取决于当前这一帧,还取决于上一帧。帧堆叠把最近4帧拼在一起作为状态,使得堆叠后的状态近似满足马尔可夫性:给定这 4 帧,未来转移不再依赖更早的历史。
顺带一提,针对不同的任务预处理的步骤往往不同,这里只是拿Space Invaders举个例子。
损失函数
在这之后,我们就可以开始定义DQN的损失函数。
对于传统Q-learning函数来说,更新公式如下
而DQN用参数为 的神经网络近似Q函数
我们的目的是让 逼近 ,采用均方误差MSE作为损失函数,即误差的平方取平均。系数多了个是为了后续方便微分。
随之而来的问题
DQN原始论文把问题归纳为三个:
-
观测序列存在样本相关性
在标准的监督学习里,我们假设训练样本是 i.i.d.(独立同分布) 的。但强化学习里,相邻的 是高度相关的。连续的样本来自同一条轨迹,彼此不独立。
如果把这种序列直接喂给神经网络训练,模型很难学到有用的知识。因为样本不独立,SGD 的梯度方差很大,甚至方向都不对。甚至网络会过度拟合最近的轨迹,忘记之前学过的,发生灾难性遗忘。
-
对Q值的微小更新可能显著改变策略,这会改变后续数据分布
强化学习是闭环的:
策略 → 决定采集什么数据 → 训练 Q 网络 → 更新策略 → 采集新数据 → ...
这和监督学习完全不同。监督学习里数据分布是固定的,模型更新不影响数据。但 RL 里:
- Q网络更新,会导致策略改变;
- 策略改变,会导致数据分布改变
- 数据分布改变,下一次训练的数据也会改变,Q网络需要重新适应
如此一来,训练极不稳定,容易震荡或者发散。
-
Action value(Q值)与目标值存在相关性
Q-Learning 的更新目标是:
注意:目标值里也有 ,而且用的是同一个网络!
也就是说:
被更新的量和目标里的量是同一个网络输出的。或者更数学一点:你在拟合 ,但你的目标 本身也是 算出来的。每次更新 ,目标也跟着变,这就好比你在追一个自己移动的靶子。
DQN主要用了两个模块来解决上述的所有问题。
问题的解决
DQN的解决方法是经验回放和目标网络(固定Target)。
-
经验回放,就是设置一个重放内存区replay memory。该区容量为N,N是一个可以定义的超参数。
在强化学习过程中,每次行动都将从环境中得到的四元组存放进去 ,训练时从存储区中随机抽样,这么做就其实就是把模型的轨迹拆散打乱,再给定四元组要求模型预测下一个动作。这样就消除了序列之间的相关性,同时也更有效地利用了经验,避免了灾难性遗忘。
-
目标网络,其实就是把目标网络固定住,让训练网络逼近目标值。目标网络 的参数 固定一段时间不变,让主网络 去逼近它。每隔 步,把主网络的参数复制给目标网络:。这样就切断了目标值与当前网络之间的相关性。
下面给出DQN的伪代码
Algorithm 1: deep Q-learning with experience replay.
Initialize replay memory to capacity
Initialize action-value function with random weights
Initialize target action-value function with weights
For episode do
Initialize sequence and preprocessed sequence
For do
With probability select a random action
otherwise select
Execute action in emulator and observe reward and image
Set and preprocess
Store transition in
Sample random minibatch of transitions from
Set
Perform a gradient descent step on with respect to the network parameters
Every steps reset
End For
End For
 微信
- 支付宝